
为什么课程作业会出现在采购博客上 #
一位大学讲师把“把 Transformer 塞进 FPGA”变成了本科毕业设计。四名学生在一颗 AMD Xilinx Zynq UltraScale+ MPSoC(xczu7ev) 上交付了一个可运行的 6 层 nanoGPT——片上功耗 3.9 W,无操作系统、无网络、无 GPU。我们在这里介绍它,不是因为在 FPGA 上跑语言模型有多新奇(这已经有人做过),而是因为该项目体现出的*工程纪律*,以及这种纪律能告诉元器件采购者:端侧 AI 芯片的真实约束是什么。
本文是我们从采购角度对已发布项目的解读。所有实验数据——每 token 777 ms、3.9 W、LUT/DSP 利用率、95.5% 矩阵乘法占比——均引自项目报告及其开源仓库,并非作为通用行业数字呈现。这些数字是所报告项目配置下的结果,而非 XCZU7EV 平台的通用规格。来源在文末注明。
板上实际运行的是什么 #
演示中那条蓝线是通过串口终端进行的莎士比亚风格聊天。板子以抑扬格节奏作答。这很迷人,同时也是陷阱:一个 3.9 W 的模型不该说得那么流畅。固件自身的统计揭示了原因——每次回复 `PL_matmul_calls = 1`。在此实现中,一个完整的 6 层模型每 token 需要约 73 次矩阵乘法调用。所以,流畅的演示只是一个*硬件在环展示*,而真正的全模型运行则单独打印出来,并且坦率地标记为 FAIL。
这种分离——演示与真相,两者都显示在屏幕上——是整个项目中最有价值的东西。
在碰硬件之前先建立黄金答案 #
学生们从 Karpathy 的 nanoGPT 出发:6 层、384 维、65 字符词表,在莎士比亚文本上训练。真正的交付物不是模型,而是一个逐层黄金参考——每一层的输入和输出都归档——以便后续每个硬件步骤都能对照已知正确的答案进行检查。
对采购者而言,对应关系很直接:一个可信的参考(数据手册曲线、ATE 报告、已知良好的批次)才能把“这颗料能用”从感觉变成可核查的论断。
INT8:“便利贴”式压缩 #
32 位浮点对逻辑阵列来说太胖了。团队使用了 INT8 量化,将权重压缩为 8 位定点——据报告约薄 4 倍,困惑度回退保持在约 10% 以内。权重、缩放因子和黄金值被导出为共享的 C 头文件,使软件和硬件“共用一本账”。
量化如今已是边缘推理器件(NPU、带 DSP 的 FPGA、微控制器)的默认做法。为边缘 AI BOM 选料时,要问清量化方案,而不只是看原始 TOPS。
十一个专用车间,而非一座工厂 #
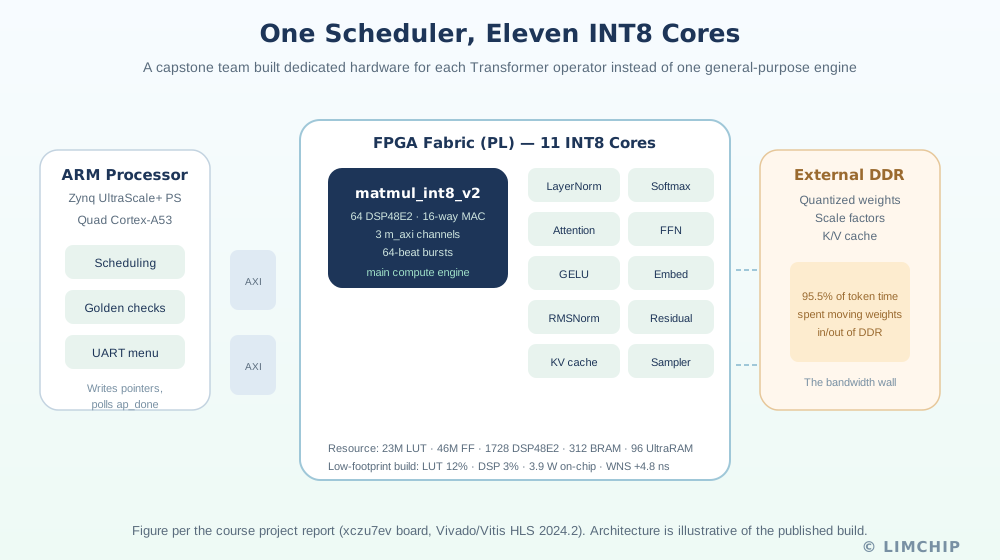
GPU 是通用工厂,而这个团队在 Vitis HLS 中做了十一个 INT8 加速器核,每个 Transformer 算子对应一个:
- `matmul_int8_v2`——主引擎:64 个 DSP48E2,16 路 MAC,三个独立的 `m_axi` 通道,64 拍突发以跑满 DDR 带宽。
- 另有 LayerNorm、Softmax、Attention、FFN、GELU、Embed、RMSNorm、Residual、KV-cache 和 Sampler 核。
十一个核全部在 100 MHz 下收敛时序;C 综合估计关键路径为 7.3 ns(约 137 MHz 上限,约 37% 余量)。验证还不止于此:综合后网表在 QuestaSim 中用 INT8 边界值(−128、127)重新仿真,语句覆盖率 100%。
同一颗 xczu7ev 上报告了两种构建:
- 小占用(已交付): LUT 12%,FF 8%,BRAM 4%,DSP 仅 3%;WNS +4.786 ns;片上功耗 3.901 W。
- 大占用(已探索): 四个 `matmul_int8_v2` 并行;LUT 52%,DSP 46%;WNS +1.614 ns;4.612 W。
同一器件、同一验证流程,两者时序都干净。交付一个稳定构建,同时探索一个更快的构建,这种风险管理才像资深工程师,而不是学生。
那张 FAIL 截图才是产品 #
全模型运行打印出的内容,正是你希望资深工程师会呈现的:
avg_ms_per_token = 777   (target ≤ 200)
status = FAIL / PARTIAL以及时间分解:777 ms 中有 95.5% 是矩阵乘法——具体来说,是权重在 DDR 中进进出出。不是乘法器慢,而是去仓库的次数太多。固件自动将该次运行标记为 FAIL,而不是把它藏起来。
这就是带宽墙,用测量而非口号陈述出来。
每 token 能耗:另一张排行榜 #
单看原始延迟,一块 RTX 5090 以约 1.93 ms/token 碾压全场。但换成每 token 能耗来排名,赢家就变了。项目设定的 200 ms *验收目标*——这是估计值,不是板级实测——下,小型 FPGA 方案估计每 token 耗电 ≤ 780 mJ,效率上胜过体量大得多的平台。这个数字由片上 3.9 W × 200 ms 一阶估算得出,并非实测的每 token 基准;而未优化的 777 ms 运行也保不住这一优势。
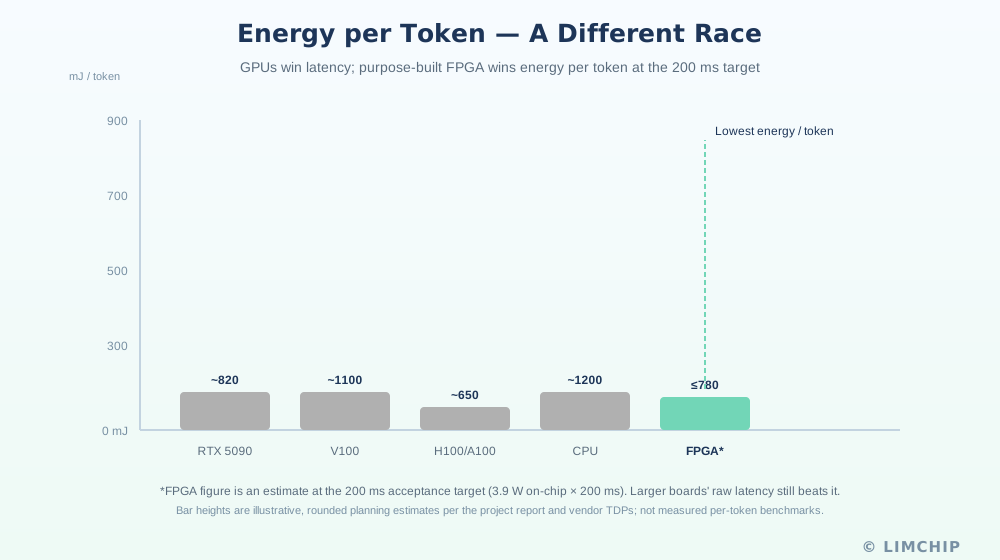
对采购来说,关键在于:“快”和“高效”是两张不同的采购订单。手机、机器人、卫星、助听器,既没有 575 W 的功耗预算,也塞不下 GPU 风扇。这正是端侧模型的下一个落点。
AI 写核,人类把关 #
本科生是怎么在一个学期内做完这些的?报告里“AI 协同开发”一节给出了答案:十一个核全部先由 AI 编码助手根据自然语言规格起草,再对照综合反馈反复迭代,直到通过。AI 负责产出,人负责把关。 把关不是一句口号,而是落到实处的:逐层黄金参考、边界值仿真(INT8 −128/127,语句覆盖率 100%),以及一个会把运行自动标记为 FAIL 而不是隐瞒的验收测试。真正的交付会附带完整的验证链——黄金参考、仿真、校验和与验收测试——这样证据可以核查,而不是靠信任。
他们甚至还额外做了一项未分配的任务:通过 hls4ml 部署 LeNet-5 数字识别,10/10 张测试图像全部识别正确。
真正的论点:定制领域专用 LLM 芯片 #
公开报道描述了 Taalas 在 2026 年 2 月的一项进展:将 Llama 3.1 8B 直接固化到硅片中(TSMC 6 nm、815 mm²、530 亿个晶体管、每用户约 14,000–17,000 token/s、约 200 W),据报道,新模型使用两次金属掩模修订,周转时间约为 2 个月。LimChip 尚未独立核实这些数字;它们仅作为报道的行业信息呈现,并非产品规格。
这和 FAIL 截图给出的教训一样:推理过程中约 95% 的时间花在搬运权重上,而不是计算。不再搬运权重,速度就能提升 1–2 个数量级。
所提出的路径——定制领域专用 LLM 芯片——将某一领域的专业知识蒸馏为约 3B 模型,量化到 INT4(约 1.5 GB),再固化到带 HBM 的 FPGA 或 ASIC 中。Token 不受限制、速度快,且数据永不离开。最适合的领域具有四个共同特征:词汇范围窄、任务封闭、对延迟/隐私敏感、不依赖开放世界知识(网络安全、工业维护、太空/无人系统、医疗/法律、离线教育)。
多 FPGA LLM:学术路线已经铺好 #
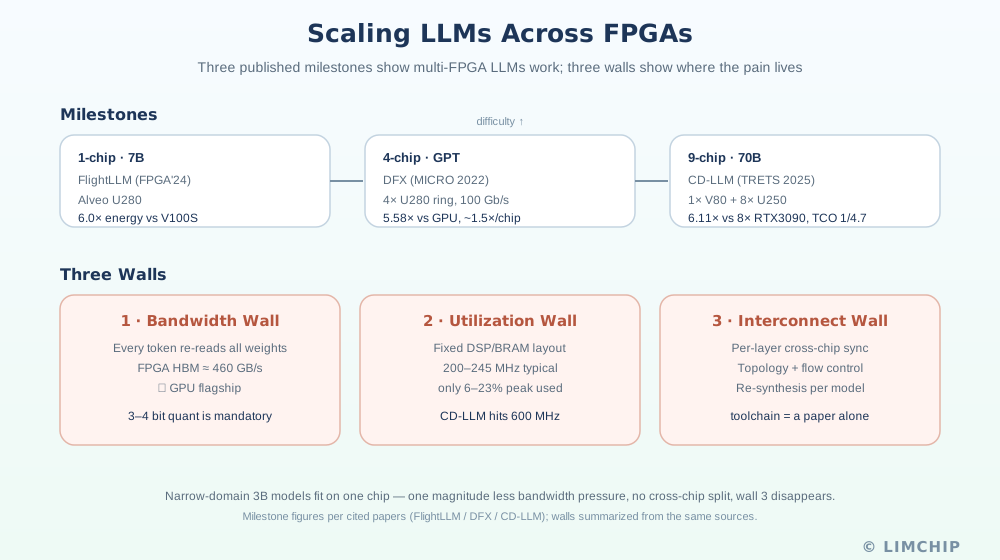
怀疑几块 FPGA 能否运行真正的 LLM?文献表明并非如此:
- 1 芯片 7B — FlightLLM(FPGA'24): Alveo U280,权重驻留片上解码;能效为 V100S 的 6.0×,成本效益为 1.8×,Versal 变体在吞吐量上优于 A100。
- 4 芯片 GPT — DFX(MICRO 2022): 四块 U280 组成 100 Gb/s 环形互连;相比 GPU 为 5.58×,能效为 3.99×;每增加一块芯片约提升 1.5×(通信开销使理想的 2× 打折扣)。
- 9 芯片 70B — CD-LLM(TRETS 2025): 一块 V80(HBM,注意力)+ 八块 U250(矩阵乘法);Llama-3.1-70B 平均 3.45-bit;相比 8× RTX3090 为 6.11×,TCO 降低 4.71×。
仍有三堵墙,而它们正是买家应内化的采购约束:
- 带宽墙——每生成一个 token 都要重新读取全部权重;FPGA HBM 约为 460 GB/s,仅为旗舰 GPU 的一小部分。因此 3–4 bit 量化是必须的,没有别的选择。
- 利用率墙——DSP/BRAM 布局固定,大多数设计的主频上限只有 200–245 MHz,仅为峰值的 6–23%;CD-LLM 采用面向计算的专用布局,可达 600 MHz。
- 互连墙——跨芯片同步要逐层进行,需要定制拓扑与流控,每换一个模型还要重新综合数小时。
窄域 3B 模型可放进单块芯片:带宽压力少一个数量级,无需跨芯片拆分,第 3 道墙也就不存在了。正因如此,领域专用的小模型才是更平缓的那条路。
采购须知 #
- xczu7ev / Zynq UltraScale+ MPSoC 仍是能力足够、广泛可得的嵌入式 AI 平台,但 16 nm UltraScale+ 的交期和产能分配可能拉长——量产要提早规划。
- 带 HBM 的 FPGA(Versal V80、Alveo U280/U250 级别)才能真正缓解带宽墙。这类器件稀缺且昂贵,第二供应源要尽早验证。
- 量化配方 + 验证资产(黄金向量、边界用例)属于交付物,不是文书工作。记得索取。
- “定制领域 LLM 芯片”不再是科幻——Taalas 和多 FPGA 论文给出了一条可信但适用范围窄的路径。如果你的应用符合上述四个特征,就值得做设计探索,而不是观望。
LimChip 不备货 xczu7ev 教育板,但可为量产采购 Zynq UltraScale+ 和 Versal 系列。如果你正在做嵌入式 AI 硬件,欢迎发起 RFQ,我们会梳理可用性和交期。
六个要点 #
- 先定标尺,再动手——写硬件之前先归档黄金参考。
- 把验收放进交付物——一个密钥就能复现每一项声明。
- 演示和真相都摆在屏幕上——诚实的 FAIL 胜过流畅的虚构。
- 速度和效率是两场不同的比赛——GPU 赢在延迟,专用硬件赢在每 token 能耗。
- AI 协同开发:AI 产出,人类把关——验证更密集,杠杆更大。
- 定制领域专用 LLM 芯片的门槛并不高——窄模型 + 固定权重 + 几块 FPGA,在合适的问题上就能胜过数据中心。
来源 #
- 来源:网络交换FPGA 微信公众号,原文系列《把大模型塞进FPGA》。
- 开源项目仓库:zcxsince2005 / My_Transformer_on_fpga。
- 器件参考:AMD Xilinx Zynq UltraScale+ MPSoC 产品文档。
- Taalas HC1 信息:EE Times 和 heise 报道。
所有板级数字(777 ms/token、3.9 W、利用率、95.5% 矩阵乘法)都是所报道项目配置下的结果,并非 XCZU7EV 平台的通用规格。每 token 能耗数字是在 200 ms 验收目标下的估算值,并非板级测量值。