
来源说明 #
本文是基于网络交换FPGA微信公众号系列文章《把大模型塞进FPGA》及所链接的开源项目仓库,由LimChip进行的英文改写与采购分析。
简短回答:架构胜过芯片 #
多年来,端侧AI的思路一直是“换一颗更大的芯片”。中国的一门大学课程刚刚给出了相反的结果。八名学生参加了上一届学生未能通过的同一考试——在一块大型 AMD Xilinx Zynq UltraScale+ xczu7ev 开发板上将 6 层 nanoGPT(莎士比亚语料库,384 维,65 词元词表)移植到FPGA上——但新一届学生用的是小得多的 Zynq-7000 XC7Z020 开发板。
在这一报道的项目配置中,XC7Z020 构建的词元延迟比早先的 XCZU7EV 实现约低 6.0 倍(每词元 129.5 ms 对 777 ms),而所报道的实现中LUT用量约低 4.3 倍。这不是笔误:一颗资源规模约小八倍的芯片,延迟却改善了六倍。在所报道的实现中,LUT与延迟的综合对比产生了约 48 倍的产品差异;这不是一般性的器件评级。对于任何采购FPGA或构建边缘AI原型的人来说,这一教训值得一读。
两代方案,两种取舍 #
上一届把 Transformer 拆到 11 个专用加速器 IP 上——每个操作一个(LayerNorm、注意力、矩阵乘法、FFN 等)。在硅资源富余的大器件上,这种“以面积换速度”的布局很容易实现。新一届用的器件逻辑资源只有前者的零头,于是拆掉这些模块,只留 一个共享计算核心,由状态机调度,让 Q/K/V 投影、注意力、残差和 FFN 轮流使用同一个乘法器模块。业界称之为 时分复用。
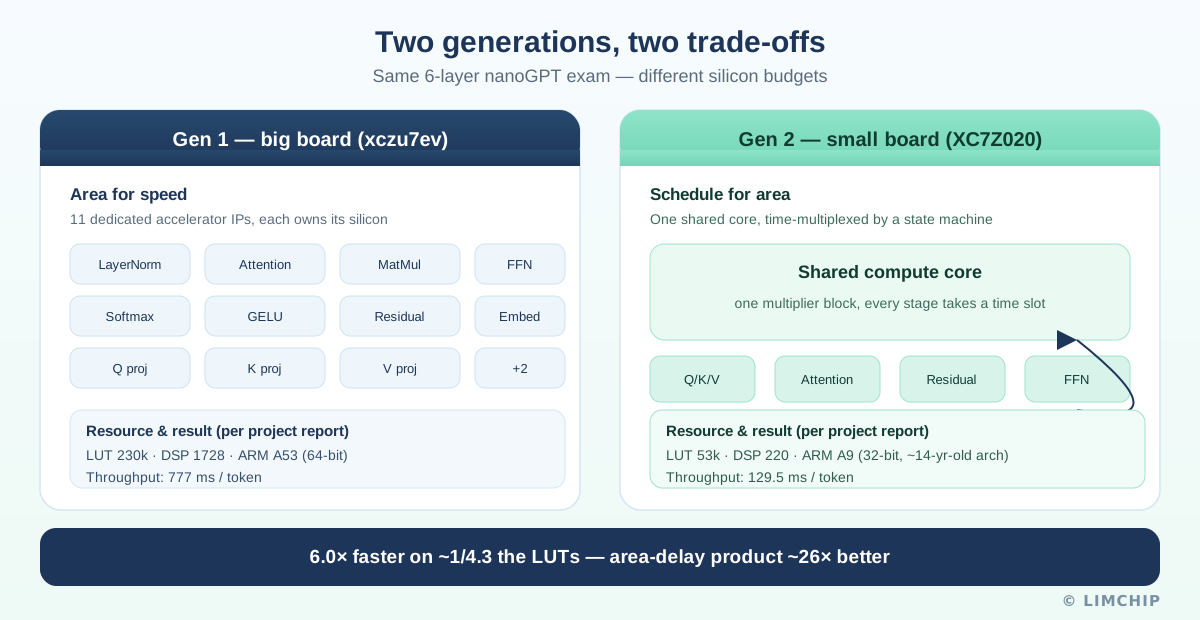
下面的资源和结果数据来自该项目布线后的 Vivado 报告:
| 第 1 代 (xczu7ev) | 第 2 代 (XC7Z020) | |
|---|---|---|
| LUT | ~230k | ~53k(已用 51.9%) |
| DSP | 1728 | 220(已用 114) |
| ARM 核心 | 64 位 A53 | 32 位 A9(约 14 年前的架构) |
| 词元延迟 | 777 ms | 129.5 ms |
BRAM 是小板上最紧张的资源,占用 77.9%——很接近上限,但最终收敛了。对采购者来说,关键在于:受限的器件逼出了纪律,而大器件则让团队可以跳过这一步。
决策 1——合并工作坊 #
把 11 个加速器合并成一个共享核心,是小板能跑起来的首要原因。代价是调度器更复杂(写状态机得头脑清醒),但正因如此,一个 6 层 Transformer 才装得进去,LUT 用量刚过一半。这就是 ASIC 和 FPGA 工程师的日常手艺:让一平方米干三平方米的活。规划边缘 AI 设计时,先问问你的 BOM 买的是 *硅资源* 还是 *调度纪律*——后者更便宜,前者往往只是图个方便。
决策 2——绝不算已经算过的东西 #
价值最高的举措反而最简单。生成模型会针对每个先前词元重新计算注意力;一个词元的 Key(K)和 Value(V)一旦算出就不再改变。上一届学生为每个新词元重新计算所有先前的 K/V——正确,但浪费。新一届学生将 K/V 存入 DDR 内存(K/V 缓存),只计算新的一行。整个 6 层笔记本占用约 1.1 MiB 内存,省掉了约 100 倍的冗余计算。
vLLM 和 TensorRT-LLM 背后的思路也是如此——只不过这次是本科生在教学板上复现出来的。有个细节他们处理了,生产级技术栈也会处理:量化比例一变,缓存就整体清空,而不是复用不匹配的旧数据。管理这一切的 ARM 程序,代码加数据不到 30 KB。
决策 3——一次只调一颗螺丝 #
团队没有推倒重来,而是分四个已签核的步骤迭代(用板测均值,不是仿真):
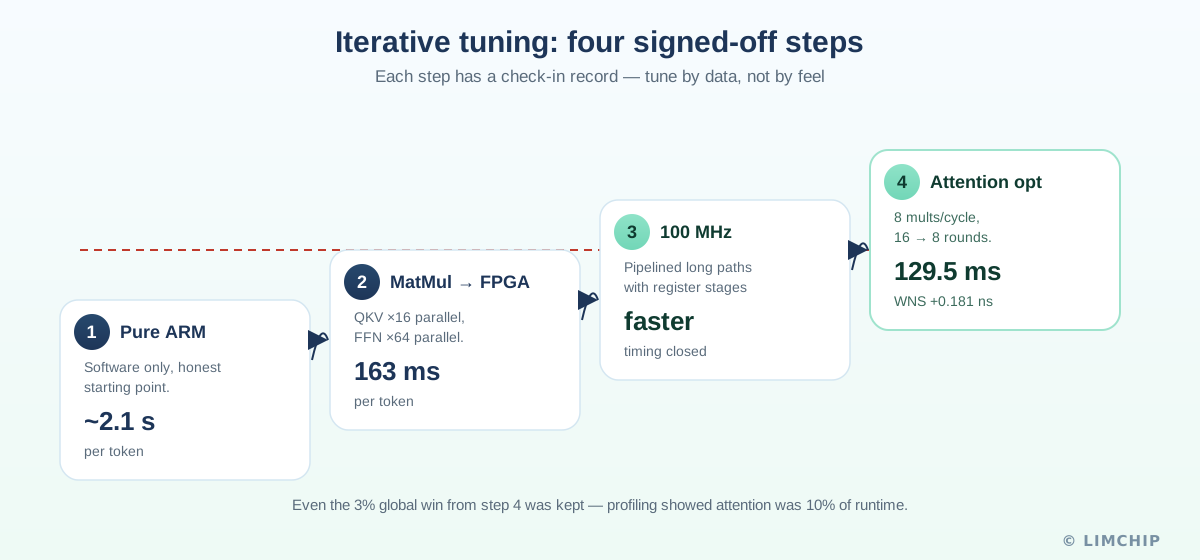
- 纯 ARM 软件——约 2.1 s/token。一个诚实的基线。
- 矩阵乘法移入 FPGA——Q/K/V 投影 16 路并行,FFN 64 路并行——降到 163 ms。
- 频率提到 100 MHz——用寄存器流水线切断长组合路径,时序得以收敛。
- 注意力优化——每周期 8 次乘法,64 维头从 16 轮减到 8 轮——最终 129.5 ms/token,时序报告 WNS +0.181 ns,TNS 0。
第 4 步全局只换来约 3%,但他们还是做了,因为性能分析显示注意力约占运行时的 10%。依据数据调优,而非凭感觉——这个习惯比任何具体工具都更有价值。
129 ms 花在哪里:带宽墙 #
优化了三周,矩阵乘法在运行时中的占比只从 95.5% 降到 90.8%。原因是结构性的:生成每个 token 都要从内存中搬运数千万个权重。如果瓶颈在搬运,算得再快也没用。团队直接给它起了名字——带宽墙,每一款 AI 加速器都会撞上的同一堵墙。下一个目标也已标出:仅 FFN 就占运行时的约 48.7%。
对采购者来说,这才是真正值得记住的一点:在边缘 AI 上,内存带宽和容量往往比峰值 MAC 数量更重要。乘法器更多、但内存更慢更小的器件,会输给数据搬运更好、更紧凑的器件。
PPA 记分卡 #
芯片工作看三个字母——性能、功耗、面积。这个项目把每一项决策都换算成了数字:
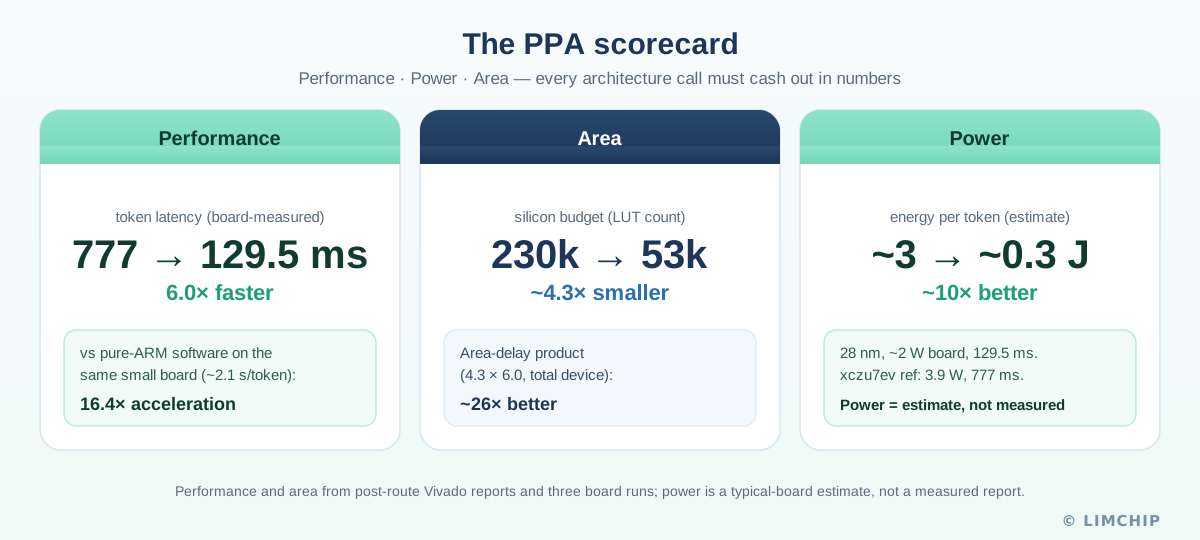
- 性能: 777 ms → 129.5 ms(延迟约降低 6.0×,基于所报告的实现和测试条件);相比之下,同一块小板上的纯 ARM(约 2.1 s)为 16.4×。均为板级实测。
- 面积: 在所报告的实现中,LUT 用量约降低 4.3×;面积-延迟积约改善 26×(基于所报告的实现和测试条件,4.3 × 6.0,按器件总资源计)。
- 功耗: 此前的 xczu7ev 报告约为 3.9 W(≈3 J/token);这块小的 28 nm 板功耗约为 2 W,因此约为 0.3 J/token——在项目所述的板级功耗假设下,估计改善约 10×,主要来自 6× 的加速。
报告中有一点需要如实说明,我们保留:功耗是典型板级估算,不是本项目的实测报告。性能和面积数据来自布线后 Vivado 报告以及三次板级运行。
成功的验证比失败更严格 #
上一期最常被引用的时刻,是一份诚实的“FAIL”打印输出。本期没有 FAIL——反而在验证上投入更多:模拟器逐算子对齐(全部六层零失配)、4,224 个中间字节与黄金参考逐字节比对(0/4224)、端到端 200 个 token 生成与定点参考比对(0/200),以及三次完全相同的重跑,以排除侥幸运行。INT8 困惑度回归报告为 4.06%,用的是*与板级相同的严格位精确路径*——他们指出更宽松的方法结果会更好看,但拒绝采用。比特流和程序随附 SHA-256 校验和。
对采购来说,可借鉴的教训枯燥但实在:要验证链,不要演示视频。 要求对方提供黄金参考比对、时序报告和校验和——定制 FPGA 或 ASIC 交付尤其如此。
它仍然会出错的地方(以及为什么这很重要) #
输入“everything with a man”,200 个字符就是莎士比亚风味的胡言乱语——生造词、重复的“sea/world/war”循环。每个 token 对数学而言都是位精确的,但模型对语言的掌握受限于一个仅用莎士比亚、65 个字符训练的 1000 万参数模型。实现的正确性和模型的能力是两场不同的考试。硬件工程师能通过第一场;第二场需要更大的模型、更多数据,以及——正如报告所论证的——一个验证层,让系统知道何时不应被信任。
嵌入式 AI 买家为何要关注 #
报告给出三个读者视角,并附上我们的采购注解:
- 好奇的读者: 一块几百美元的教学板就能说明,大模型并非只存在于云端的神秘魔法。FPGA 是一块可反复擦写的“空白芯片”——本科生在上面加载了一个能写莎士比亚的模型,每个比特都能给你看。
- 学生 / 转行者: 价值在于一次难得的全栈实践——Python 训练 → INT8 量化 → HDL → 时序收敛 → 裸机驱动 → 板级验证。“在 FPGA 上跑通 Transformer,逐 token 对齐全部通过”比十张课程证书更有说服力。
- 从业者: 一块几美元的板子就能复现生产级 LLM 推理芯片的核心矛盾——带宽墙、面积与时序的权衡、KV-cache 开销、量化的真实代价。
采购 XC7Z020 与 Zynq-7000 系列 #
项目中的板卡是 AMD Xilinx Zynq-7000 XC7Z020——一款 28 nm SoC,将 32 位 ARM Cortex-A9 与 7 系列 FPGA 逻辑阵列集成在一起。该系列生命周期长、有多家供应商可供货,对买家来说是好事,但也正因为年代久、出货量大,成为假冒风险较高的系列。
| 检查项 | 需确认的内容 |
|---|---|
| 确切型号 | XC7Z020 有多种后缀(如 -1/-2 速度等级、-CLG400/-SBG485 封装、C/I/E 温度等级)。确认确切的订购代码。 |
| 封装与 MSL | 回流焊前核实球间距、封装代码和湿敏等级。 |
| 日期码 | Zynq-7000 已成熟;确认可接受的年/周范围,并确认该器件不是拆机件或报废回收件。 |
| 可追溯性 | 要求批次一致性和供应商文件;该系列年代久远,假冒和翻新件很常见。 |
| 交期 | 成熟的 Xilinx 器件在产能配额紧张时交期仍可能拉长;在 BOM 定稿前确认当前报价交期。 |
采购注意事项: 本项目所用的 XC7Z020 属于特定器件和板卡配置。文中测得的速率、功耗和资源占用,只对应这一具体实现和测试条件,并不代表 Zynq-7000 系列的所有型号。购买前请确认准确的订购型号——速度等级、封装、温度等级——以及具体的板卡版本和 Vivado 工程约束;该系列不同型号的范围和后缀差别很大。
LimChip 的产品目录目前还没有 XC7Z020 或其他 Zynq-7000 型号,所以这里不提供库存页面链接。如果你需要 XC7Z020、Zynq-7000 同系列型号,或用于边缘 AI 设计的 Zynq UltraScale+ 器件,请提交 RFQ,我们会按经批准的制造商和后缀来采购。
更值得关注的:小型 Transformer 是一条真实的赛道 #
报告通过文献梳理,回应了一个合理的质疑——“在 FPGA 上跑这么小的模型有什么意义?”——三个层面正在同时推进:
- 小型任务 Transformer 已接近部署。 在比 XC7Z020 更小的 Spartan-7 器件上,4 位模型已能以亚毫焦耳成本完成预测、分类和异常检测;ZU 板上的视觉 Tiny Transformer 速度约为 ARM A53 的 10 倍,能效约为 7 倍。
- 0.5B–1.7B 边缘模型正在原型验证。 ZCU102 上的 TinyLlama 1.1B、KV260 上的 Qwen2.5-0.5B,以及亚 2 位实验都表明,边缘 SLM 现在的问题已不是“能不能跑”,而是“怎么跑才划算”。
- 7B–8B 正在试探嵌入式极限。 4 GB KV260 上的 LLaMA2-7B 和通过权重卸载运行的 LLaMA3-8B,在内存带宽接近上限时能达到每秒几个 token。
一位读者问了个关于卫星的问题——FPGA 能否运行像 NASA JPL 的 Gemma-3-4B 演示那样的轨道 VLM?——对此的回答需要拿捏分寸:高端 FPGA(或 FPGA+GPU/NPU)可以,办法是把视觉编码器 + mmproj + 4B 解码器拆开,但 2.4 GB 的 Q4 模型加上运行时和 KV cache,512 MB 的教学板装不下。脉冲/事件驱动的视觉前端还能进一步压缩前端。实话实说:XC7Z020 这一级别跑不了 Gemma-3-4B;先从视觉前端和投影入手,再攻 4B 解码器。
结论 #
XC7Z020 项目清楚地说明了一件事:架构比硅片更重要。共享的分时复用核心、K/V 缓存,加上数据驱动的逐步调优,比单纯买一块更大的板卡更管用——而且每一项结论都有可查证的验证链,买家可以自行审计。做边缘 AI 采购,真正长期管用的规则其实很朴素,但能省钱:先看内存带宽,再看 MAC 数量;要求供应商提供黄金参考验证链;对 Zynq-7000 这类成熟且容易被仿冒的系列,务必核对料号后缀。上文给出的延迟、功耗和资源数据只针对本报告所述的这块 XC7Z020 构建及其测试条件,并非 Zynq-7000 的通用性能,未经重新验证不要套用到同系列其他型号上。
如果你正在用 Zynq、Artix、Spartan 或 Zynq UltraScale+ 做开发,需要可靠的货源,请带上确切的料号、数量和日期码范围,发起 FPGA / Zynq 询价。
来源 #
- 网络交换FPGA 微信公众号,原文系列《把大模型塞进FPGA》。
- nanoGPT on Zynq — XC7Z020 期末项目仓库。
- My Transformer on FPGA — xczu7ev 项目仓库。
- AMD Xilinx Zynq-7000 产品文档。
- 相关 FPGA transformer 研究论文(例如 FlightLLM、DFX、CD-LLM 及相关学术工作)。
文中所有性能、面积和功耗数据均来自该项目实际实现与测试条件下的报告结果,不代表 Zynq-7000 系列的通用规格。功耗为板级估算值,并非本项目的完整实测功耗报告。