
GB300 领跑首批 AA-AgentPerf 结果——但这个结论需要结合背景来看 #
NVIDIA 的 Blackwell Ultra GB300 NVL72 在 Artificial Analysis 的 AA-AgentPerf 首次发布中取得了领先成绩。该基准围绕真实的编码智能体工作负载设计,而不是单一的聊天补全测试。
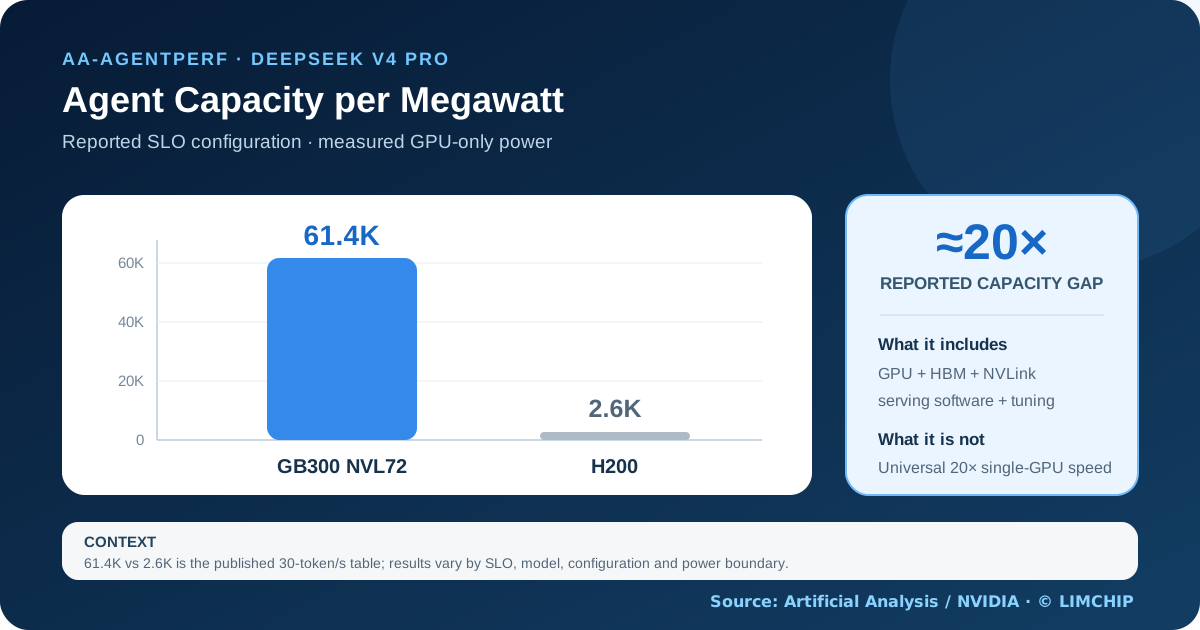
最引人注目的是,在报告所述的 DeepSeek V4 Pro 服务等级目标下,GB300 NVL72 每兆瓦的并发智能体容量约为 H200 系统的 20 倍。NVIDIA 还报告了一种配置,每兆瓦可支持约 61,400 个并发智能体,每 GPU 57.5 个;而 H200 对比方案为每兆瓦 2,600 个、每 GPU 1.4 个。
这一点很重要,但并不等于说所有 GB300 工作负载都比 H200 快 20 倍。该结果衡量的是:经过调优的服务系统在满足指定延迟和 token 速率目标的前提下,能保持多少个编码智能体同时活跃。它综合了 GPU 架构、HBM、机架级互连、推理软件和系统调优等多方面因素。
| 报告的 AA-AgentPerf 对比 | NVIDIA GB300 NVL72 | NVIDIA H200 | 衡量内容 |
|---|---|---|---|
| 每兆瓦并发智能体数 | 61.4K | 2.6K | 按实测 GPU 功耗归一化的服务容量 |
| 每 GPU 并发智能体数 | 57.5 | 1.4 | 在测试服务等级下的硬件利用率 |
| 主要提升幅度 | 约 20× | 基线 | 在报告的 20 和 60 token/s 目标下的每兆瓦容量 |
61.4K 这一数字来自 NVIDIA 公布的表格,对应 30 token 每秒的服务等级配置。其他目标下的结果有所不同,因此不应将其作为适用于所有部署的固定容量数字来呈现。
为什么智能体工作负载需要不同的基准 #
AI 智能体不只是回答一个提示。编码智能体可能会检查文件、调用工具、修改计划、生成补丁、读取测试输出,并持续多轮。上下文可能大幅增长,而单个响应仍呈突发性。因此,平台需要管理长提示、重复的 KV-cache 访问、混合专家路由以及大量并发会话,同时不允许用户可见延迟恶化。
AA-AgentPerf 回放编码智能体轨迹,并不断增加并发量,直到系统无法再满足所选服务等级目标。其三个实际维度是:
| 指标 | 在生产智能体服务中的含义 | 运营者为何关注 |
|---|---|---|
| 首 token 时间(TTFT) | 从发出请求到生成首个 token 之间的延迟 | 决定智能体在工具循环中是否感觉响应迅速 |
| 输出生成速率 | 每个活跃请求每秒生成的 token 数 | 影响生成开始后的任务完成时间 |
| 并发智能体容量 | 在维持 SLO 的前提下支持的活跃智能体数量 | 将基础设施成本和功耗与可售服务容量联系起来 |
对于 DeepSeek V4 Pro,Artificial Analysis 定义了三个公布层级:20 token/s 且 P95 TTFT 不高于 10 秒,60 token/s 且 P95 TTFT 不高于 5 秒,以及 180 token/s 且 P95 TTFT 不高于 3 秒。该基准使用的输入长度约为 1K 至 131K token,均值约为 27K,以更好地代表不断变化的智能体上下文。
GB300 结果背后的原因 #
这一结果是机架级系统的成果,而不仅仅是 GPU 更快的成果。GB300 NVL72 通过高带宽 NVLink 域连接 72 个 Blackwell Ultra GPU。NVIDIA 的提交还使用了围绕 SGLang、TensorRT-LLM、vLLM、专家并行和融合混合专家 kernel 的服务与通信优化。
这一点很关键:大型混合专家模型在加速器之间搬运激活值、协调专家工作负载,往往要花掉大量时间。算力再多,也得靠内存容量、内存带宽、纵向扩展 fabric 和软件调度把它喂饱,否则就是闲置。所以这个基准考察的是整个服务栈。
| 系统层 | 对智能体容量的贡献 | 采购影响 |
|---|---|---|
| 加速器和 HBM | 模型执行、KV cache 和活跃上下文容量 | GPU/HBM 产能配额和合格平台可用性仍是主要约束 |
| NVLink 和网络 | 专家流量和多 GPU 协调 | 交换机、光链路、线缆和连接器必须与拓扑匹配 |
| 机架供电 | 支撑密集且快速变化的加速器负载 | 大电流功率级、控制器、电容器和母排设计需要验证 |
| 液冷 | 在机架级功率密度下散热 | CDU、manifold、泵、冷板和泄漏检测的准备情况会影响部署时间 |
| 服务软件 | 批处理、路由、缓存和 kernel 效率 | 每项性能声明都必须记录框架和版本 |
在容量规划中使用“20×”之前需要记住的四个限制 #
第一,AA-AgentPerf 按实测的仅 GPU 功耗归一化,包括 GPU 裸片和 HBM 功耗。CPU、网络、存储和冷却功耗不计入。这是一个有用的加速器效率指标,但它不是总设施功耗或完整数据中心的 PUE。
第二,NVIDIA 提交的是经过调优的 B300/GB300 配置,而 H200 对比配置由 Artificial Analysis 构建。Artificial Analysis 明确指出,H200 和 AMD MI355X 系统可能还有额外的优化空间。发布表格是一个透明的快照,而不是永久的上限。
第三,该对比跨越不同的系统规模和软件栈。一个 72 GPU 的 NVL72 机架和一个八 GPU 的 H200 服务器并不能单独隔离架构因素。买家应将该结果视为部署平台对比。
第四,该基准目前聚焦于 DeepSeek V4 Pro 编码智能体轨迹。模型架构、量化、上下文分布和工具行为都可能实质性改变排名。在做出采购决策之前,应使用预期的生产模型复现结果。
商业信号:每兆瓦智能体数可能成为采购指标 #
对于智能体服务而言,仅凭峰值 FLOPS 并不能定义营收能力。如果一个机架能够在所需的延迟和功耗范围内维持更多并发会话,那么运营商在相同付费用户数量下,可能需要更少的机架、更少的电力容量和更少的冷却。
这使采购讨论的焦点转向每个活跃智能体的成本,而不仅仅是每块 GPU 的成本。但计算时必须涵盖完整的基础设施账单:加速器系统、主机 CPU、网络、存储、电源转换、冷却、软件许可、占地面积和利用率。
这一结果还带动了 GPU 周边的需求,而不只是 GPU 本身。高密度 AI 机架需要经过验证的电源管理器件、大电流连接器、电容器、重定时器、光学组件、管理控制器和冷却硬件。供应风险可能出现在这些支撑层中的任何一层。
RFQ 与产能规划核对清单 #
在比较 GB300、H200 或其他加速器方案之前,请索取可复现的配置记录:
- 确认确切的型号版本、精度、量化方式以及可接受的精度阈值。
- 针对预期工作负载,定义 P50/P95 TTFT、输出 token 速率和并发目标。
- 记录输入/输出长度分布、工具调用频率和 KV-cache 假设。
- 说明功耗是指仅 GPU、服务器输入功率、机架功率还是设施功率。
- 记录 GPU 数量、拓扑、框架、内核版本和并行设置。
- 在 TCO 中纳入网络、存储、CPU、冷却和电气升级成本。
- 确认产能配额、交期、保修、区域服务和更换单元条款。
必须确认整个机柜级 BOM 的可用性。GPU 的报价交期并不能保证网络、电源和冷却组件会在同一时间就绪。
接下来是什么:Rubin 的说法仍属路线图数字 #
NVIDIA 表示,其即将推出的 Vera Rubin 平台将提供高达 50 PFLOPS 的 NVFP4 算力,并改善工具调用和端到端智能体性能。这些数字描述的是 NVIDIA 的路线图;它们并非实测的 AA-AgentPerf 结果,不应与当前的 GB300 表格混为一谈。
更持久的启示比某一代产品更为广泛。智能体 AI 正在推动加速器评估从孤立的基准吞吐量转向持续的、符合 SLO 的服务容量。AA-AgentPerf 为买家提供了一个有用的新视角——但配置、功耗边界和优化责任必须与每一个头条数字一同呈现。
来源与方法论 #
- Artificial Analysis,“AA-AgentPerf: Benchmarking AI Hardware for Agentic Workloads”,2026 年 6 月 12 日。
- NVIDIA Technical Blog,“NVIDIA Achieves Leading Agentic Coding Performance on First Agentic AI Benchmark.”
- Artificial Analysis 针对 AA-AgentPerf 公开的硬件配置披露。
以上数据来自基准测试结果和厂商公开资料,并不保证量产性能或元器件供货情况。在正式下达量产采购订单之前,请在实际选定的平台上验证目标模型和服务级别目标。