
只要模型、量化和运行时都针对平台来选,现在完全可以在 RK3588 开发板上跑推理模型。一个实用的例子是用 Rockchip 的 RKLLM 工具链转换 DeepSeek-R1-Distill-Qwen-1.5B,再通过 RK3588 NPU 执行。这样就能支持离线助手、设备文档搜索、本地文本分析等对隐私敏感的边端应用,不必把每条提示都发到云端 API。
“本地运行”并不代表每块 RK3588 板子的速度都一样。内存容量和带宽、RKLLM 版本、RKNPU 驱动、量化设置、上下文长度、CPU/NPU 时钟、散热以及提示的形态,都会影响最终结果。因此本指南给出了一条可复现的部署路径,并让所报告的基准测试结果始终对应经过测试的配置。
本示例采用用户提供的 YY3588 板配置,以及 RKLLM 1.2.2 转换/运行时栈。Rockchip 的公开仓库一直在更新,所以新的部署应先查看当前版本及其兼容性说明,不要盲目照搬版本号。
为什么 1.5B 蒸馏模型适合这一边端目标 #
DeepSeek 基于 Qwen 和 Llama 系列发布了六个稠密蒸馏检查点。DeepSeek-R1-Distill-Qwen-1.5B 是该系列中最小的官方检查点,基于 Qwen2.5-Math-1.5B。DeepSeek 表示,其蒸馏模型使用 DeepSeek-R1 生成的推理样本进行了微调,使小得多的模型能够复现大模型的部分推理行为。
因此,1.5B 检查点很适合作为 RK3588 的首选目标,因为它缓解了边端部署的三个难题:
- 量化后模型权重占用的内存大幅减少。
- 预填充和 token 生成对内存带宽的持续压力更小。
- 转换和板端调试比 7B 或 14B 级模型更快完成。
代价是能力。1.5B 蒸馏模型并不等同于完整的 DeepSeek-R1 服务,基准测试分数也不能保证在工业指令、安全决策或特定领域问题上的可靠性。本地部署应包含针对具体应用的评估、输出约束以及回退路径。
硬件与软件边界 #
Rockchip 规定 RK3588 配备四个 Cortex-A76 和四个 Cortex-A55 CPU 核心,以及一个额定最高 6 TOPS 的 NPU。RKLLM 支持 RK3588 系列,并将 DeepSeek-R1-Distill 列为其支持的模型系列之一。这些官方声明确立了平台能力,而载板则决定了 RAM、存储、散热设计和对外接口。
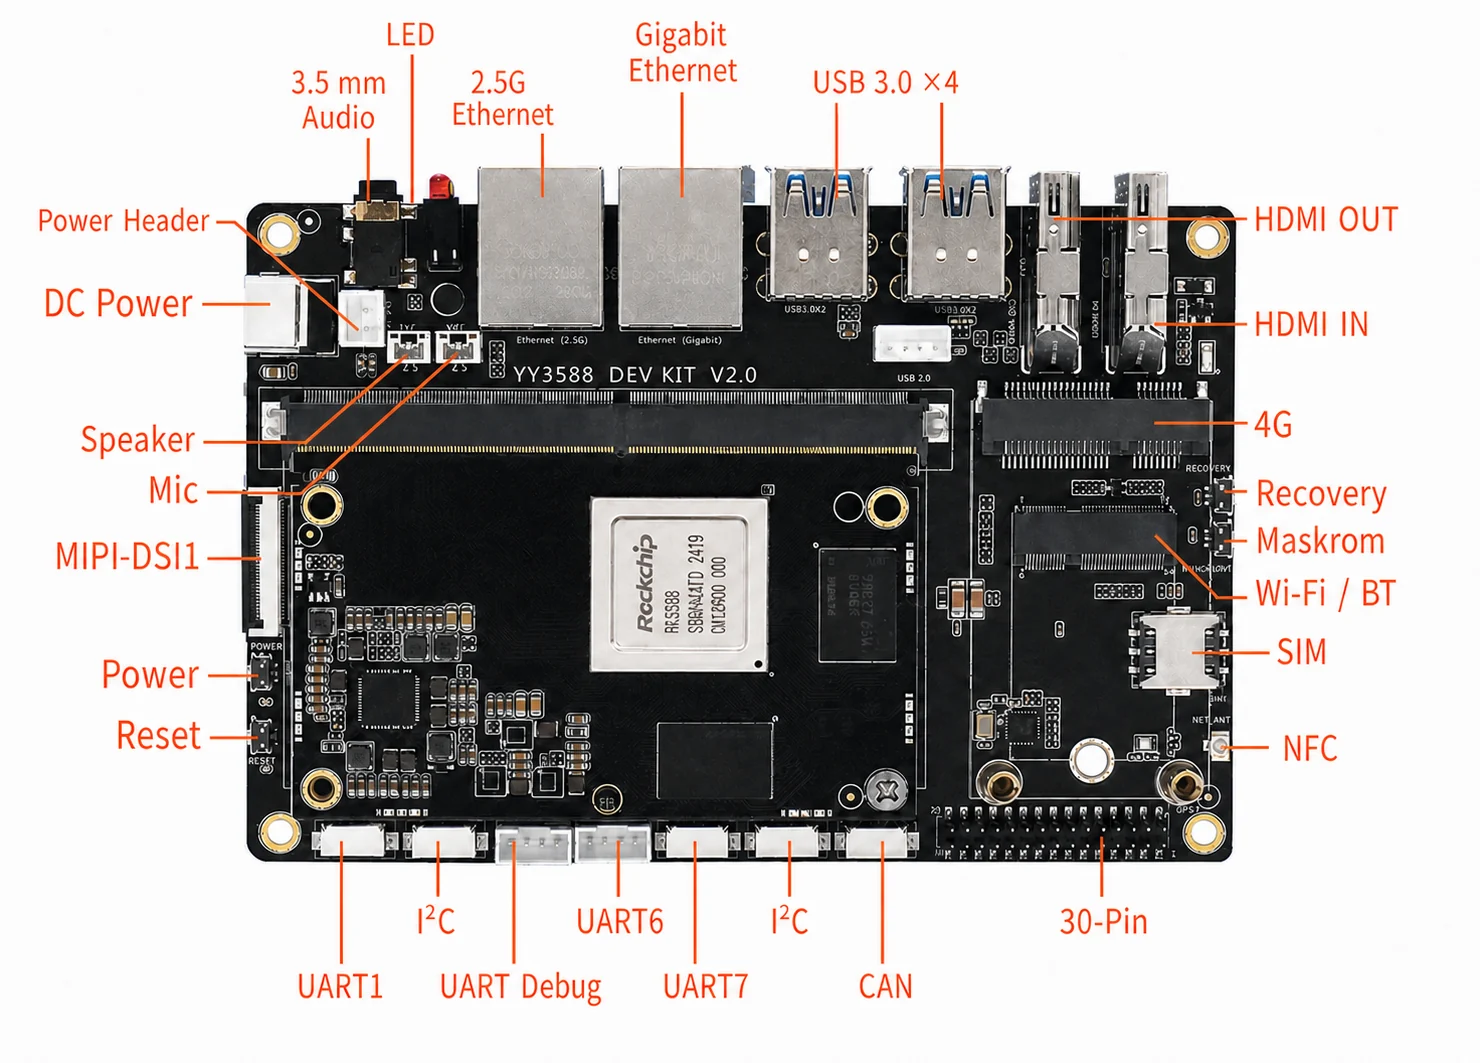
图示的 YY3588 配置提供双以太网、多个 USB 端口、HDMI 输入/输出、串行总线、CAN、无线扩展以及可拆卸的计算模块。这些标签描述的是图中所示的板卡版本;不应将其推广到每一块 RK3588 板。对于订单或项目发布,请确认当前原理图、模块版本、RAM/eMMC 配置和 BSP 镜像。
对于此类模型,请将以下内容作为规划指导,而非通用最低要求:
| 资源 | 实际规划要点 |
|---|---|
| RAM | 所报告的测试在模型推理时峰值约为 1.84 GB;还需为 Linux、运行时、提示缓存和应用程序预留额外内存 |
| 存储 | 为源检查点、转换后的 `.rkllm` 文件、运行时库、日志和回滚镜像保留空间 |
| 散热 | 持续生成 token 时应测试是否出现时钟降频,不能只测室温启动时的情况 |
| NPU 驱动 | 必须与所选 RKLLM 运行时和板卡 BSP 兼容 |
| 主机 PC | 模型转换使用 x86-64 Linux 主机,并配备受支持的 Python 环境 |
RKLLM 部署流水线 #

RKLLM 将转换与推理分开。主机侧工具包导入 Hugging Face 格式的检查点,进行优化和量化,然后导出 Rockchip `.rkllm` 模型。目标侧运行时加载该文件,并由 ARM64 应用程序调用 NPU 驱动。
这些组件必须作为一个兼容性整体来考虑:
- x86-64 转换机上的 RKLLM Toolkit。
- RK3588 板上的 RKLLM Runtime 库。
- 随板卡 BSP 提供的 RKNPU 内核驱动。
- 转换后的 `.rkllm` 模型,其中记录了目标平台和量化选项。
- 与对应运行时链接的 C/C++ 演示程序或应用程序。
把旧的转换模型和任意新运行时混用,可能导致加载失败、输出变化甚至崩溃。每发布一个模型,都要记录仓库标签、wheel 文件名、运行时库哈希、驱动版本和转换命令。
步骤 1:获取并验证官方检查点 #
请使用官方 `deepseek-ai/DeepSeek-R1-Distill-Qwen-1.5B` 模型仓库,不要用名称相似的社区转换版本。Hugging Face 风格的目录通常包含配置、分词器以及一个或多个权重文件。
为便于采购和部署管控,请记录以下内容:
- 模型仓库及确切版本或提交。
- 蒸馏模型及其基础模型的许可证文件。
- 下载后的文件哈希。
- Git LFS 是否已完成,而不是只留下指针文件。
- 所选 RKLLM 版本要求的分词器或配置修改。
DeepSeek 的模型卡为 R1 系列推荐了特定的生成设置,并提醒评估应进行多次重复试验。请在测试计划中保留这些建议,不要仅凭单个提示就判断模型表现。
步骤 2:创建隔离的转换环境 #
所提供的部署记录使用了 Ubuntu 24.04、Python 3.12,以及为 x86-64 Linux 上 CPython 3.12 构建的 RKLLM Toolkit 1.2.2 wheel。由于这只是一个有日期标记的测试栈,并非永久要求,请先查看当前 Rockchip 仓库中的软件包矩阵。
隔离环境可防止工具包的依赖项改动系统 Python:
python3 -m venv rkllm_venv
source rkllm_venv/bin/activate
pip install ./rkllm_toolkit-1.2.2-cp312-cp312-linux_x86_64.whl
不要仅仅因为文件名看起来接近就选择某个 wheel。要匹配 RKLLM 版本、Python ABI、操作系统和主机架构。将 wheel 本身保留在构建归档中,以便之后复现该模型。
步骤 3:准备具有代表性的量化数据 #
转换工作流在构建量化模型时会使用校准数据集。Rockchip 的示例树中包含用于从模型目录生成 `data_quant.json` 文件的脚本。源过程使用了:
python3 generate_data_quant.py -m ./DeepSeek-R1-Distill-Qwen-1.5B/校准数据会影响激活范围,进而影响精度。用通用样本生成的文件拿来做首次演示或许够用,但生产模型应当用能代表其真实语言、长度和领域的提示来评估。量化验收时,应在固定评估集上把输出与源检查点做对比。
步骤 4:构建 W8A8 RK3588 模型 #
测试所用转换采用 W8A8 分组量化、三个 NPU 核心、4096 token 的最大上下文,目标平台为 RK3588。基本结构如下:
from rkllm.api import RKLLM

converter = RKLLM()
converter.load_huggingface(
    model="./DeepSeek-R1-Distill-Qwen-1.5B",
    model_lora=None,
    device="cpu",
)
converter.build(
    do_quantization=True,
    optimization_level=1,
    quantized_dtype="w8a8_g128",
    quantized_algorithm="normal",
    num_npu_core=3,
    dataset="./data_quant.json",
    hybrid_rate=0,
    target_platform="rk3588",
    max_context=4096,
)
converter.export_rkllm(export_path="./deepseek-r1-distill-qwen-1.5b.rkllm")
实际构建脚本中应检查每个返回码,并保存控制台日志、工具包版本和输出哈希。优化级别、量化类型、上下文或混合率一旦变化,就要新建模型产物,不要覆盖旧文件,否则性能和输出质量已无法直接比较。
W8A8 改变了什么 #
`W8A8` 将权重和激活量化为 8 位表示,`g128` 在此工作流中表示组大小为 128 的分组量化。这样做可以减少内存占用,也可能提升 NPU 执行效率,但模型输出可能发生变化。正确的测试不只是看模型能否回答,而是看对于预期提示,精度、稳定性、内存和速度是否仍然可接受。
步骤 5:对齐板端运行时和驱动 #
复制模型之前,先确认板端镜像所暴露的 NPU 驱动。在 RK3588 Linux 目标上,可用的调试节点取决于 BSP,但所提供的流程通过内核调试文件系统检查了 Rockchip NPU 驱动版本。
目标应用需要 ARM64 的 RKLLM 运行时库和转换后的模型。在 Android 上,源记录把 `libomp.so` 和 `librkllmrt.so` 放在专用的应用目录下,并用 Android NDK r21e 构建 Rockchip 演示程序。在 Debian 上,库的放置位置和构建路径不同,但规则一样:头文件、库、模型和驱动必须来自经过验证的组合。
生产镜像不要依赖手动修改的 shell 环境。把库打包到受控路径下,指定服务账户和权限,启动时校验模型哈希,并在每次启动推理服务时记录运行时和驱动版本。
步骤 6:运行推理并测量整个系统 #
源配置以 1024 token 输入、2048 token 输出的设置启动了 Rockchip 演示程序:
RKLLM_LOG_LEVEL=2 \
LD_LIBRARY_PATH=/data/rkllm/lib:$LD_LIBRARY_PATH \
./llm_demo ./deepseek-r1-distill-qwen-1.5b.rkllm 1024 2048
在该用户提供的测试中,运行时日志报告约为 8 输出 tokens/s、约 1.84 GB 峰值内存,生成期间 NPU 活动约为 75%。这些数据来自一块板、一个模型构建、一个提示和一套软件栈,并非 RK3588 的保证规格。较早的源叙述还提到了更高的 15.4 tokens/s,但没有同样清晰的测试记录,因此本文不将其用作已验证基准。
一份可信的基准报告应包含:
| 测量项 | 所需上下文 |
|---|---|
| 首 token 时间 | 输入长度、缓存状态和时钟 |
| 预填充吞吐量 | 提示 token 和提示结构 |
| 解码吞吐量 | 输出长度、采样设置和多次运行的平均值 |
| 峰值内存 | 模型/上下文设置,以及该数字是进程内存还是系统内存 |
| NPU/CPU 利用率 | 测量脚本、间隔和活动核心 |
| 温度和时钟 | 散热器/风扇、环境温度和降频状态 |
| 输出质量 | 评估提示以及与源模型的比较 |
“流畅”与否取决于具体应用。对本地维护助手来说,每秒八个 token 可能已经够快,但长思维链响应仍可能耗时很久。应测量完整答案的延迟和任务成功率,而不只是稳态解码速度。
首次成功运行后的优化优先级 #
控制上下文长度 #
KV 缓存会随上下文增长。把上限设为 4096 个 token,并不意味着每个应用都要一直用满。应限制检索到的文档数量、对对话历史做摘要,并在超大请求造成内存压力之前将其拒绝。
让模型服务保持热启动 #
对于偶发性的工作负载,模型加载和首次运行初始化可能占用大部分时间。可以用一个受监管的服务把模型加载一次,对外提供本地 API,并按内存预算串行处理请求。同时加上健康检查和有上限的重启策略,而不是每来一个提示就新起一个进程。
将热测试与功能测试分开 #
五分钟的演示可能根本达不到密封工业机箱内的温度。应在摄像头、存储和网络服务都运行的情况下反复发送提示,并持续观察 CPU/NPU 时钟和 token 延迟的变化。
评估量化效果,而不只是看转换是否成功 #
至少构建一个覆盖预期语言和任务的参考评估集,比较原始检查点与 `.rkllm` 产物在事实性、格式、拒绝行为和推理一致性上的差异。如果换一种量化方式能提升速度,应在发布前把质量上的取舍明确展示出来。
保护本地端点 #
离线推理改善了数据本地性,但监听中的服务仍可能泄露提示词、模型输出,或被用来访问系统。应只绑定必要的接口,对客户端做身份验证,清理日志,限制提示词长度,并把模型生成的命令当作不可信输入处理。
板卡采购与部署检查 #
用于本地 LLM 推理的 RK3588 板卡,不能只看处理器型号。批量下单前,请确认以下事项:
- RK3588/RK3588S 模块和载板的确切版本。
- 已装 LPDDR 容量,以及内存供应商/物料变更是否经过批准。
- eMMC 或 SSD 的容量、耐久性、接口和量产供应情况。
- 持续 NPU 负载下的散热方案。
- Debian/Android BSP 版本、内核、RKNPU 驱动及更新策略。
- 源码、设备树和恢复镜像是否可获得。
- 电源输入范围,以及 NPU 负载切换时的掉电表现。
- 所订购版本上引出的以太网、USB、显示、摄像头和工业接口。
- 模型/运行时的许可义务,以及可复现的构建归档。
- 板卡 BSP 和 RKLLM 应用的长期支持负责人。
询价时,请注明板卡数量、RAM/eMMC 配置、操作系统、所需接口、温度范围、散热方式,以及供应商是否必须预装指定镜像或模型文件。如果性能写入合同,请附上确切的基准测试流程,而不是只写一句“DeepSeek-R1 必须流畅运行”。
结论 #
在 RK3588 上做本地推理模型推理,DeepSeek-R1-Distill-Qwen-1.5B 是一个切实可行的起点。Rockchip 的 RKLLM 栈提供了官方支持的转换和运行时路径,W8A8 量化则把模型压缩到适合边缘设备的内存级别。随附的测试表明,在一种 YY3588 配置上,推理速度约为 8 tokens/s,峰值内存约 1.84 GB,本地输出可用。
真正可复用的成果是这套工作流程,而不是那个用来宣传的速度数字:锁定模型版本,对齐工具包、运行时和驱动的版本,用有文档记录的量化数据来构建,在持续负载下测量整块板卡,并针对实际应用验证输出质量。做到这些,RK3588 上的 DeepSeek 演示才能变成可维护的边缘 AI 产品。
官方参考 #
- DeepSeek-R1 官方模型仓库和蒸馏模型文档
- DeepSeek-R1 官方 GitHub 仓库
- Rockchip RKLLM 官方仓库
- Rockchip RKLLM 发布和兼容性说明
- Rockchip RK3588 官方开发板公告
- Rockchip RK3588 简要数据手册